“클로드에는 XML 태그를 쓰고 챗GPT에는 마크다운 헤더를 써라.” 프롬프트 구조를 다루는 글에서 거의 공식처럼 반복되는 조언입니다. 그런데 이 말을 뒷받침하는 실측을 본 적이 없어서 직접 확인해 봤습니다. 내용이 완전히 같고 구획 문법만 다른 프롬프트 두 벌을 만들어 클로드와 챗GPT에 각각 넣고, 조건을 몇 개나 지키는지 셌습니다.
2026년 8월 1일 실행: 클로드는 claude.ai 웹(모델 표시
Opus 5 높음), 챗GPT는 chatgpt.com 임시 채팅(모델GPT-5.6 Sol, 추론 수준높음)에서 돌렸습니다. 각 조합을 서로 다른 새 대화에서 한 번씩 실행했습니다.
📌 핵심 요약
- 각 사 공식 문서를 확인해 보니 “클로드는 XML, 챗GPT는 마크다운”이라는 이분법 자체가 문서 내용과 다릅니다. OpenAI는 마크다운과 XML을 둘 다 안내합니다.
- 조건 5개짜리 프롬프트로 네 조합을 돌린 결과 전부 5/5였습니다. 구획 문법에 따른 준수 차이는 나오지 않았습니다.
- 대신 모델별 차이가 일관되게 나왔습니다. 같은 “40자 이내” 조건에서 클로드는 평균 35자, 챗GPT는 평균 23자를 썼습니다.
이 글은 이런 분께 추천합니다: 여러 AI 모델을 함께 쓰는 실무자, 프롬프트를 팀 템플릿으로 관리하는 담당자
공식 문서가 실제로 말하는 것
먼저 두 회사 문서를 직접 열어봤습니다. 흔히 도는 이분법과는 내용이 달랐습니다.
Anthropic 프롬프트 엔지니어링 문서는 XML 태그를 권장합니다. 다만 조건이 붙습니다. 복잡한 프롬프트에서, 지시·맥락·예시·변수 입력이 섞여 있을 때 오해를 줄인다는 설명입니다. 각 종류를 <instructions>, <context>, <input> 같은 자기 태그로 감싸라고 안내합니다.
OpenAI 프롬프트 엔지니어링 가이드는 마크다운만 말하지 않습니다. 마크다운 헤더와 목록이 구획을 나누고 위계를 전달하는 데 유용하다고 안내합니다. 그리고 XML 태그도 함께 권합니다. 참고 문서처럼 한 덩어리가 어디서 시작하고 끝나는지 표시할 때 쓰라는 설명입니다.
즉 “한쪽은 XML, 다른 쪽은 마크다운”이 아닙니다. 한쪽은 XML을 강조합니다. 다른 쪽은 둘 다 쓰라고 합니다. 그리고 두 문서 모두 어느 쪽이 성능이 더 좋다는 비교 수치는 제시하지 않습니다.
직접 돌려본 방법
관건은 판정에 논쟁 여지를 없애는 것이었습니다. “이쪽 답이 더 낫다” 같은 인상 비교는 보는 사람에 따라 갈립니다. 그래서 조건을 전부 기계로 셀 수 있게 짰습니다.
과제는 반려동물 사료 쇼핑몰의 고객 후기 6개를 분류하고 대응 문구를 쓰는 것입니다. 조건은 다섯 개입니다.
- 분류는 긍정·부정·중립 중 하나만 쓸 것
- 대응 문구에 사과 표현(죄송·사과·미안)을 쓰지 말 것
- 결과를 표로 정리할 것
- 각 대응 문구는 40자 이내로 쓸 것
- 맨 마지막 줄에 부정 후기 건수만 숫자로 적을 것
다섯 개 다 답을 보면 바로 셀 수 있습니다. 사과 단어가 들어갔는지, 40자를 넘겼는지, 마지막 줄이 숫자인지는 눈대중이 필요 없습니다.
그다음 같은 내용을 두 벌로 만들었습니다. 구획 문법만 다르고 나머지는 글자 하나까지 동일합니다.
XML판입니다.
<role>
너는 반려동물 사료를 파는 온라인 쇼핑몰의 CS 담당자야.
</role>

<task>
아래 고객 후기를 감정으로 분류하고 부정적인 후기에는 대응 문구를 함께 작성해줘.
</task>

<rules>
1. 분류는 긍정, 부정, 중립 중 하나만 쓸 것
...
</rules>

<reviews>
1. "배송이 너무 늦었어요"
...
</reviews>
마크다운판입니다.
## 역할
너는 반려동물 사료를 파는 온라인 쇼핑몰의 CS 담당자야.

## 작업
아래 고객 후기를 감정으로 분류하고 부정적인 후기에는 대응 문구를 함께 작성해줘.

## 조건
1. 분류는 긍정, 부정, 중립 중 하나만 쓸 것
...

## 후기
1. "배송이 너무 늦었어요"
...
여기서 실수하기 쉬운 지점이 있습니다. 처음 만든 두 판은 어순과 어미가 미묘하게 달랐습니다. 한쪽은 역할을 먼저 두고 다른 쪽은 작업을 먼저 뒀고, “담당자다”와 “담당자야”처럼 문장 끝도 어긋나 있었습니다. 그대로 돌렸다면 결과 차이가 구획 문법 때문인지 문구 차이 때문인지 구분할 수 없었을 겁니다. 구획 표시를 걷어낸 뒤 나머지를 문자 단위로 비교해 차이가 0이 될 때까지 고쳤습니다.
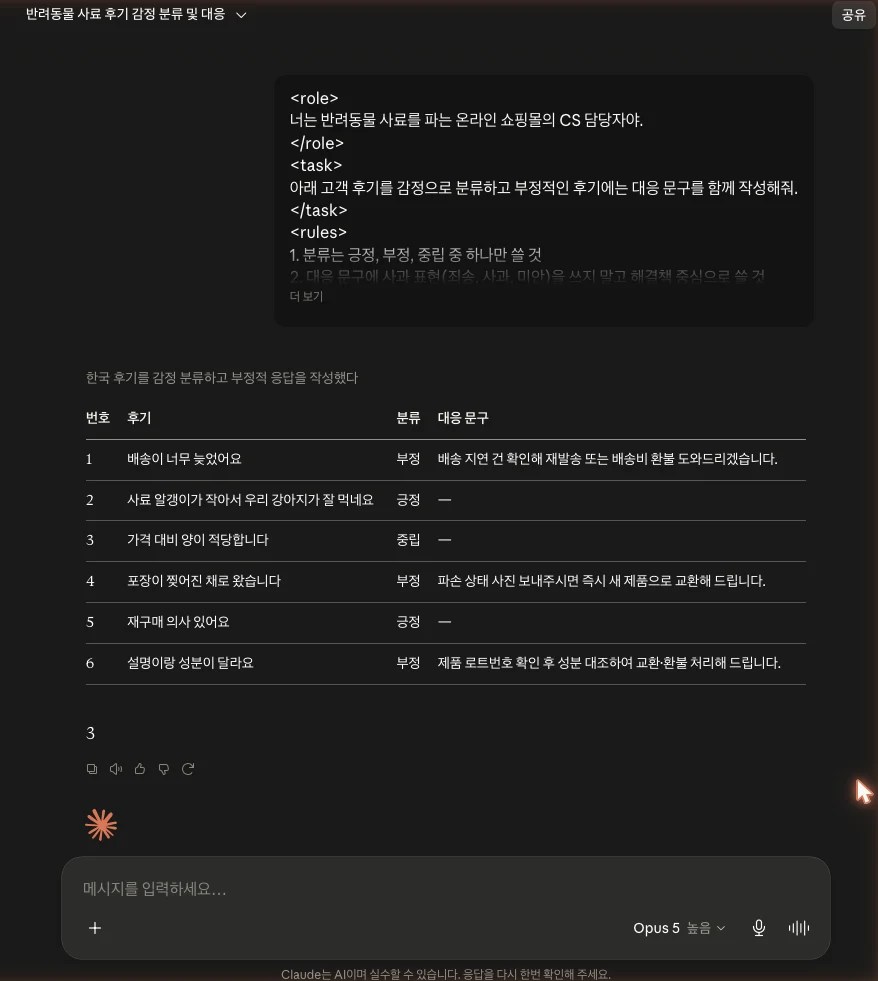
Opus 5 높음입니다. (2026-08-01 실행)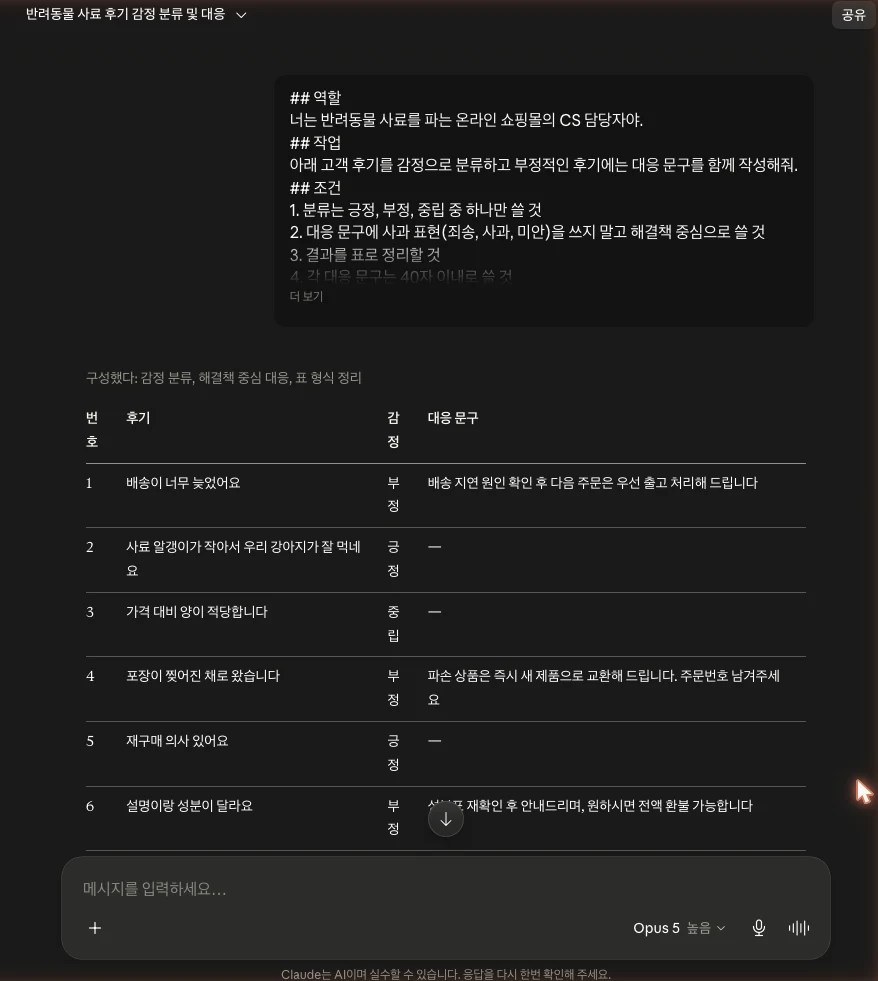
분류에서 감정으로 바뀐 정도가 차이입니다. (2026-08-01 실행)결과: 네 조합 모두 5/5
| 조합 | 조건 준수 | 대응 문구 최장 | 평균 |
|---|---|---|---|
| 클로드 × XML | 5 / 5 | 36자 | 35자 |
| 클로드 × 마크다운 | 5 / 5 | 37자 | 35자 |
| 챗GPT × 마크다운 | 5 / 5 | 24자 | 23자 |
| 챗GPT × XML | 5 / 5 | 24자 | 24자 |
같은 모델 안에서 XML판과 마크다운판의 결과가 같았습니다. 클로드에 마크다운으로 줘도 조건 다섯 개를 다 지켰고, 챗GPT에 XML로 줘도 마찬가지였습니다.
이 결과는 “클로드는 태그로 나눠주지 않으면 지시를 놓친다”는 통념을 이 과제와 이 조건에서는 뒷받침하지 않습니다.
솔직히 적자면 저는 반대 결과를 예상하고 시작했습니다. 예상과 다르게 나왔다고 조건을 더 어렵게 바꿔가며 다시 돌리지는 않았습니다. 그렇게 하면 원하는 답이 나올 때까지 문제를 고르는 셈이 되기 때문입니다.
대신 갈린 것은 문구 길이였습니다
준수 여부는 같았지만 답의 성격은 뚜렷하게 달랐습니다. 같은 “40자 이내” 조건에서 두 모델이 여백을 쓰는 방식이 달랐습니다.
- 클로드: 두 판 모두 평균 35자. 최장 36자와 37자로 한도에 가깝게 씁니다.
- 챗GPT: 두 판 모두 평균 23자. 한도의 절반 남짓만 씁니다.
예를 들어 같은 포장 파손 후기에 클로드는 “파손 상품은 즉시 새 제품으로 교환해 드립니다. 주문번호 남겨주세요”(37자)로 답했고, 챗GPT는 “사진 확인 후 새 상품으로 교환해드리겠습니다”(24자)로 답했습니다.
주목할 점은 이 차이가 구획 문법과 무관하게 나타났다는 것입니다. 클로드는 XML이든 마크다운이든 35자였고 챗GPT는 어느 쪽이든 23자였습니다. 이 실험에서 결과를 가른 변수는 문법이 아니라 모델이었습니다.
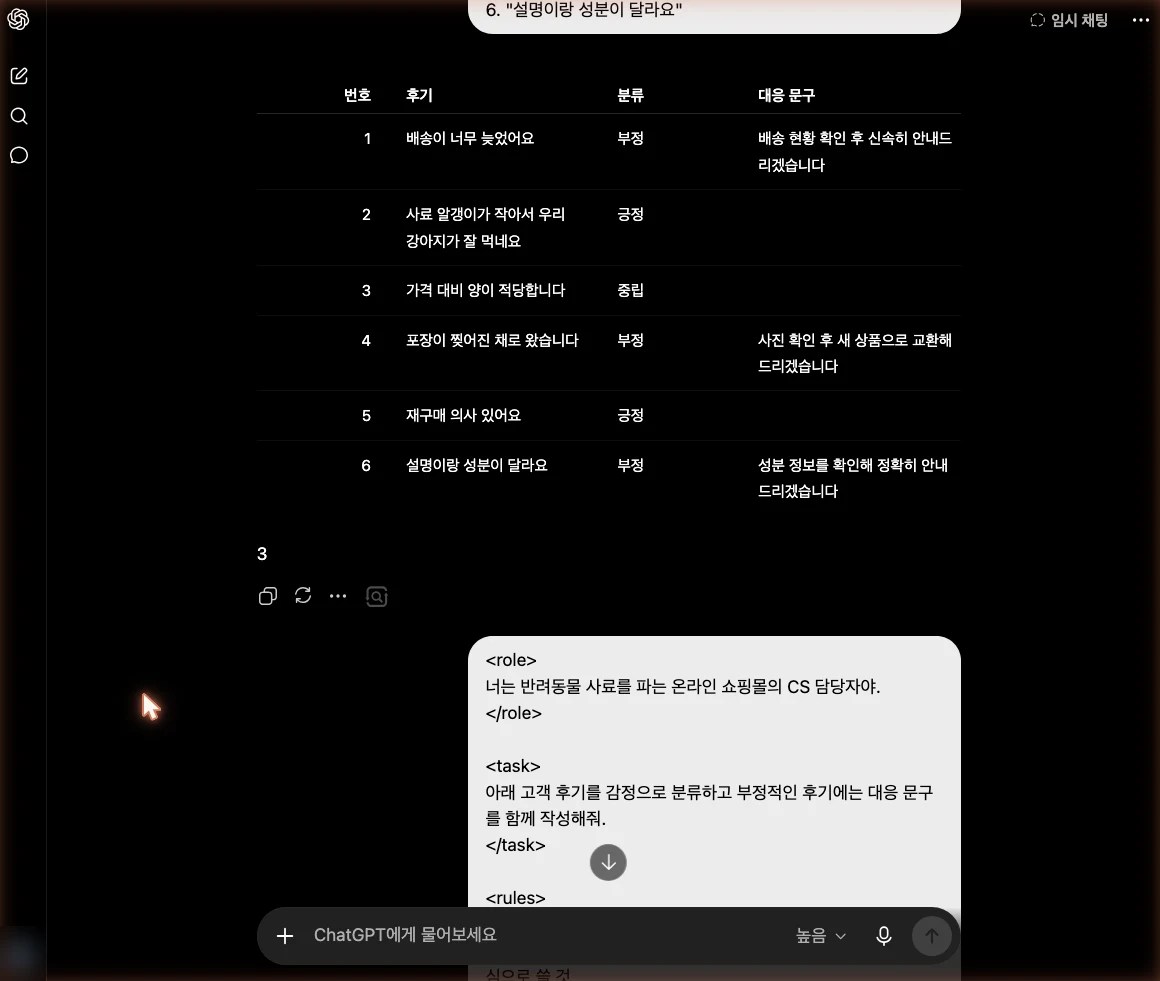
임시 채팅 표시는 이전 대화 기록이 결과에 섞이지 않게 한 것입니다. (2026-08-01 실행)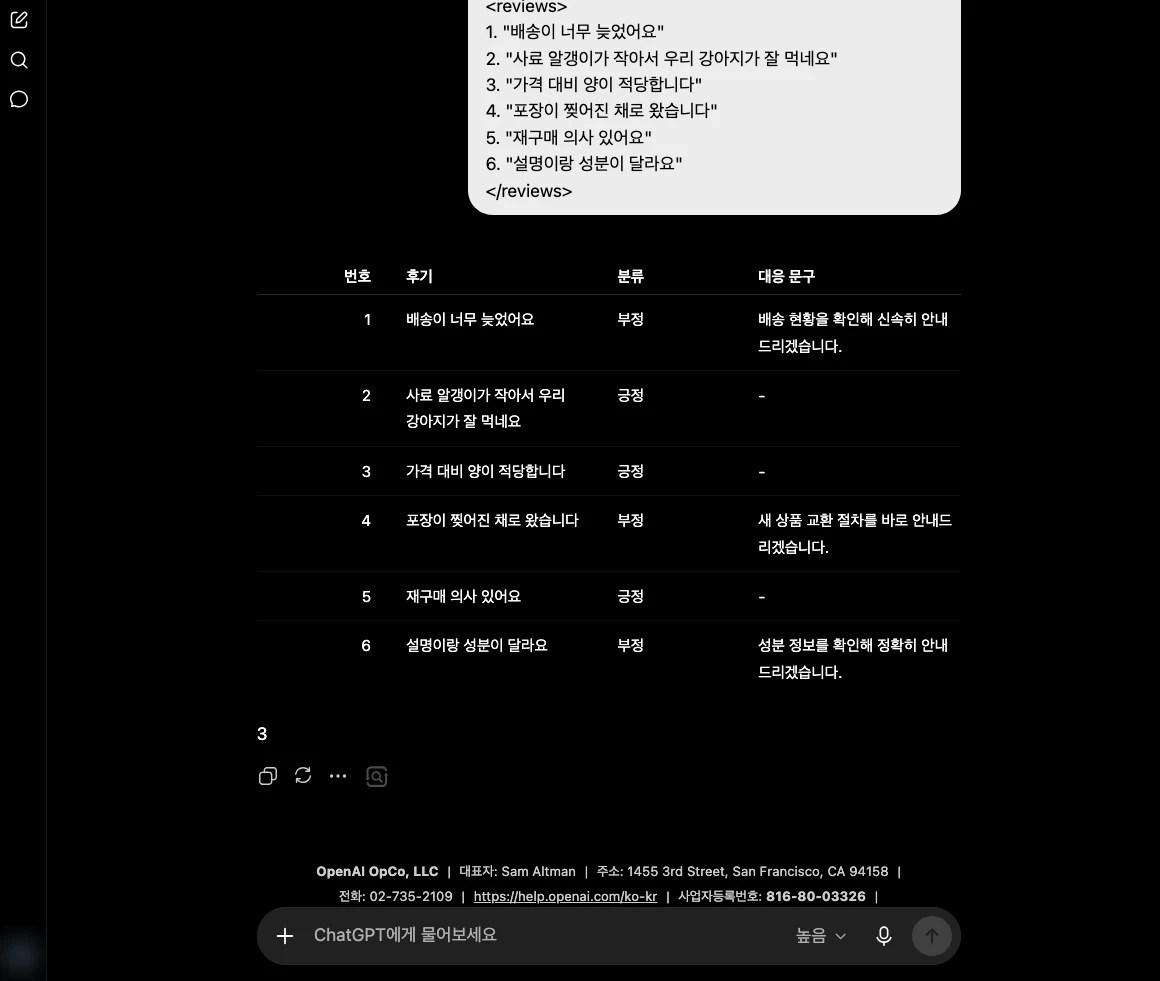
긍정으로 나왔습니다. 나머지 세 번은 중립이었습니다. (2026-08-01 실행)이 실험의 한계
이 결과를 일반 법칙으로 읽으면 안 됩니다. 한계를 그대로 적겠습니다.
조합당 한 번씩만 돌렸습니다. 통계가 아니라 관측입니다. 실제로 실행마다 달라지는 부분을 봤습니다. “가격 대비 양이 적당합니다”라는 후기를 세 번은 중립으로, 한 번은 긍정으로 분류했습니다. 조건 준수와는 별개지만 같은 입력에 같은 답이 나오지 않는다는 뜻입니다. 한 번의 결과를 근거로 삼으면 안 되는 이유가 여기 있습니다.
과제 하나, 조건 다섯 개, 한국어 한 종류만 봤습니다. Anthropic 문서가 XML을 권하는 상황은 “복잡한 프롬프트”인데, 이 실험의 프롬프트는 그 기준에서 보면 단순한 편입니다. 조건이 스무 개이거나 참고 문서가 여러 개 붙는 프롬프트에서는 결과가 달라질 수 있습니다.
2026년 8월 1일 기준 두 서비스의 웹 기본 설정입니다. 클로드는 Opus 5에 추론 노력 높음, 챗GPT는 GPT-5.6 Sol에 추론 수준 높음이었습니다. 챗GPT 모델명은 입력창에 표시되지 않아 실행 뒤 같은 계정의 모델 메뉴에서 확인했습니다. 다만 실행 화면에도 높음 표시는 남아 있습니다. 모델이나 추론 수준이 다르면 결과도 달라질 수 있습니다.
그래서 실무에서는
이 결과를 놓고 보면 순서가 달라집니다.
구획 문법을 모델마다 바꾸는 작업은 우선순위가 낮습니다. 프롬프트를 두 벌로 관리하는 비용을 생각하면, 적어도 이 정도 복잡도의 프롬프트에서는 한 벌로 쓰고 넘어가도 됩니다. 어느 쪽이든 사람이 읽고 고치기 편한 문법을 고르면 됩니다.
대신 조건을 셀 수 있게 쓰는 데 시간을 쓰는 편이 낫습니다. “정중하게”보다 “사과 표현 없이”, “짧게”보다 “40자 이내”가 낫습니다. 이번 실험에서 네 조합이 모두 만점을 받은 이유도 조건이 모호하지 않았기 때문일 가능성이 큽니다.
모델을 바꿀 때는 분량을 확인하세요. 같은 프롬프트로 클로드에서 챗GPT로 옮기면 답이 짧아졌습니다. 표에 들어갈 문구나 UI 문구처럼 길이가 중요한 작업이라면 이 차이가 바로 드러납니다.
직접 세어보는 게 가장 빠릅니다. 조건 다섯 개짜리 프롬프트 하나로 네 번 돌리는 데 몇 분이면 됩니다. 남의 결론을 옮기는 것보다 자기 업무에 쓰는 실제 프롬프트로 확인하는 편이 정확합니다.
✅ 체크리스트
- 프롬프트의 조건을 사람이 세어 확인할 수 있는 형태로 적었는가
- 두 모델을 비교한다면 프롬프트 내용이 정말 동일한지 확인했는가
- 모델을 바꿨을 때 답의 분량이 달라지는지 확인했는가
- 남의 “이 모델엔 이 형식” 조언을 자기 프롬프트로 검증해 봤는가
마무리
“클로드엔 XML, 챗GPT엔 마크다운”은 널리 퍼져 있지만 두 회사 문서가 실제로 하는 말과 다르고, 조건 다섯 개짜리 프롬프트로 네 번 돌려본 결과에서도 차이가 나오지 않았습니다. 대신 눈에 띈 것은 모델별 분량 차이였습니다.
한 번의 관측으로 일반화할 생각은 없습니다. 다만 이런 조언은 옮기기 전에 자기 프롬프트로 한 번 세어보는 편이 낫다는 것은 분명해졌습니다. 몇 분이면 됩니다.
지금 자주 쓰는 프롬프트 하나를 골라 조건을 셀 수 있는 형태로 다시 쓰고, 두 모델에 같은 내용을 넣어 비교해 보시기 바랍니다.
콘텐츠 제작·자동화와 관련된 글도 함께 보면 흐름이 잘 잡힙니다.
이 글은 프롬프트 작성법 묶음에 속합니다. 같은 주제의 글을 배우는 순서대로 묶어 두었으니 묶음 페이지에서 이어 보세요.
글쓴이 · K.Lee — 파티시에로 일하며 AI·자동화 도구를 실무에 매일 씁니다. 확인한 범위와 확인하지 못한 범위를 글 안에 밝힙니다. 운영자 소개 · 편집 원칙 · 수정 정책
답글 남기기