“한국어는 영어보다 토큰을 두세 배 먹는다.” 한국어로 AI를 쓰는 사람이면 한 번쯤 들어본 말입니다. API 비용을 계산할 때도, 긴 문서를 붙여넣다 한도에 걸릴 때도 이 말이 근거로 나옵니다. 그런데 요즘 모델에도 그대로 적용되는지 확인한 자료는 잘 안 보입니다. 직접 재봤습니다.
📌 핵심 요약
- 실측 결과 1.3~1.4배입니다. “2~3배”는 틀린 말이 아니라 낡은 말입니다.
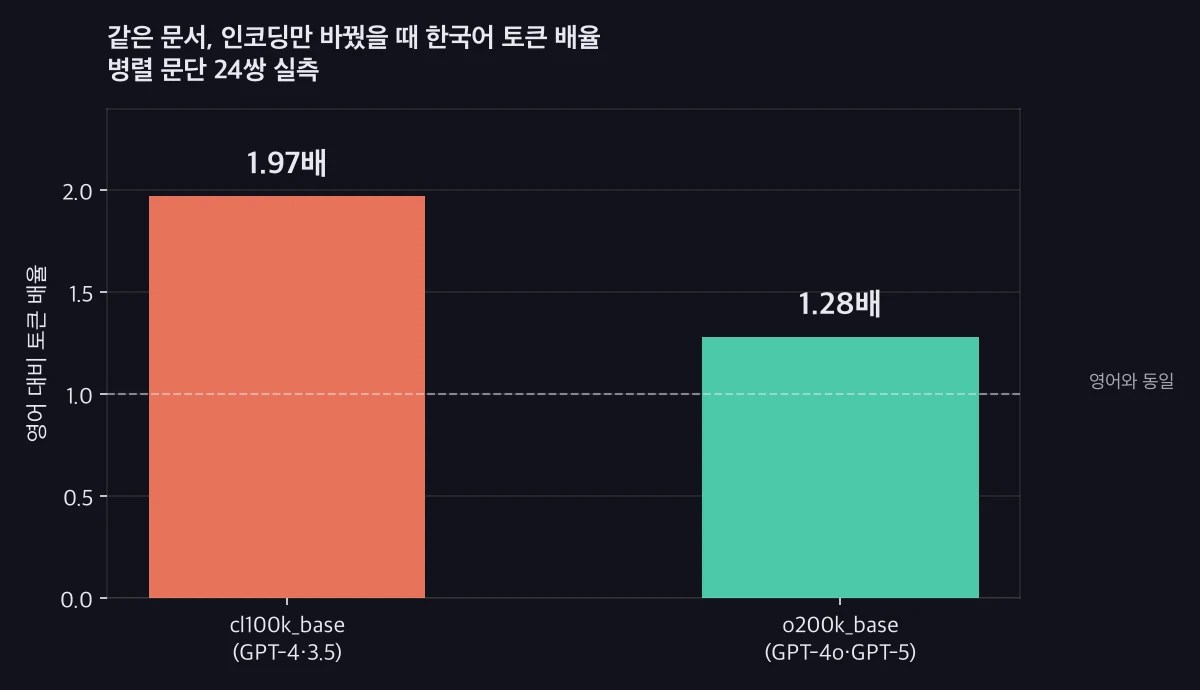
- GPT-4 세대 인코딩에서는 정말 1.97배였습니다. GPT-4o·GPT-5 세대로 오면서 절반 가까이 줄었습니다.
- 정작 비싼 건 문장이 아니라 외래어를 한글로 적을 때입니다.
프롬프트는 4토큰,prompt는 1토큰입니다.
API 비용을 직접 계산해야 하는 사람, 긴 한국어 문서를 AI에 넣다 한도에 걸려 본 사람에게 해당하는 이야기입니다.
한국어 토큰을 무엇으로 쟀나
토큰은 모델이 글을 쪼개 세는 단위입니다. 어떤 인코딩(tokenizer)을 쓰느냐에 따라 답이 달라집니다. 그래서 재료를 두 종류로 나눴습니다.
첫째는 같은 문서의 영어판과 한국어판입니다. Microsoft Learn의 Copilot 개요 문서는 /en-us/와 /ko-kr/ 주소로 같은 글이 올라가 있습니다. 문단이 1:1로 대응해서 24쌍을 그대로 떼어 썼습니다. 누구나 두 주소를 열어 대조할 수 있습니다.
둘째는 사람이 직접 쓴 실무 프롬프트 5쌍입니다. 공식 문서는 번역투라 실제 사용자가 치는 문장과 다를 수 있어서 이메일 초안 요청·회의록 정리·엑셀 수식 질문·문장 다듬기·코드 디버깅 질문을 한국어와 영어로 각각 썼습니다.
계산에는 OpenAI의 tiktoken 라이브러리를 썼습니다.
이게 실제 과금 기준과 같은지도 확인했습니다. 19토큰짜리 문장을 API로 보내니 prompt_tokens가 25로 돌아왔고, 차이 6토큰은 채팅 형식이 붙이는 상용구였습니다. gpt-5.6-luna, gpt-5-mini, gpt-5 셋 다 같은 값이 나왔습니다.
지금 과금되는 인코딩이 o200k_base가 맞다는 뜻입니다.
결과는 1.3~1.4배였습니다
| 재료 | 영어 | 한국어 | 배율 |
|---|---|---|---|
| 공식 문서 24쌍 | 952토큰 / 4,713자 | 1,216토큰 / 2,944자 | 1.28배 |
| 실무 프롬프트 5쌍 | 170토큰 | 226토큰 | 1.39배(중앙값) |
문단별로 보면 1.08배에서 1.50배 사이에 흩어집니다. 재료를 합쳐도 1.3배 근처가 중심입니다.
여기서 눈여겨볼 게 하나 있습니다. 한국어판은 글자 수가 영어판의 62%밖에 안 됩니다. 같은 뜻을 훨씬 짧게 씁니다. 그런데 토큰은 128%가 나옵니다.
글자당으로 따지면 영어가 0.202토큰, 한국어가 0.413토큰이니 글자 하나당 두 배입니다. 한국어가 압축적으로 쓰이는 덕분에 최종 배율이 1.3배 선에서 멈추는 셈입니다.
기계번역 문서라 부풀려진 것 아니냐고 볼 수도 있는데, 반대였습니다. 사람이 쓴 자연스러운 한국어 쪽이 1.39배로 더 높게 나왔습니다.
“2배”는 틀린 게 아니라 낡았습니다
같은 문서를 예전 인코딩으로 다시 재봤습니다.
| 인코딩 | 세대 | 한국어 배율 | 문단별 범위 |
|---|---|---|---|
cl100k_base |
GPT-4·GPT-3.5 | 1.97배 | 1.40 ~ 2.54 |
o200k_base |
GPT-4o·GPT-5 계열 | 1.28배 | 1.08 ~ 1.50 |
cl100k_base에서는 정말 두 배였습니다. 최대 2.54배까지 벌어진 문단도 있습니다. 그러니 “한국어는 2~3배”라고 배운 분들이 틀린 걸 배운 게 아닙니다. 그 시절에는 맞는 숫자였습니다. 어휘 사전이 10만 개에서 20만 개로 커지면서 한국어 조각이 더 많이 등재된 겁니다.
진짜 비싼 건 외래어를 한글로 적을 때입니다
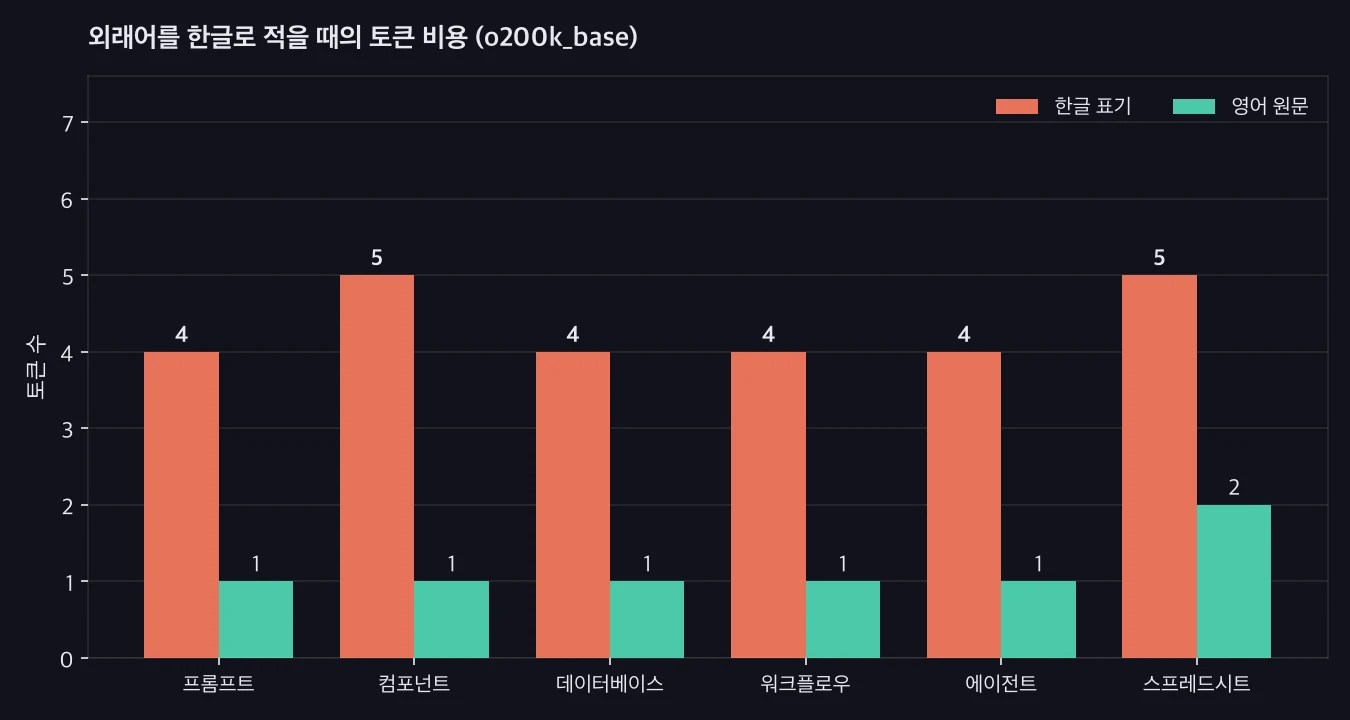
문장 단위 1.3배보다 훨씬 심한 구간이 있습니다. 영어 단어를 한글로 옮겨 적은 말들입니다.
| 한글 표기 | 토큰 | 영어 원문 | 토큰 |
|---|---|---|---|
| 프롬프트 | 4 | prompt | 1 |
| 컴포넌트 | 5 | component | 1 |
| 데이터베이스 | 4 | database | 1 |
| 워크플로우 | 4 | workflow | 1 |
| 에이전트 | 4 | agent | 1 |
| 스프레드시트 | 5 | spreadsheet | 2 |
컴포넌트 네 글자가 5토큰입니다. component 아홉 글자는 1토큰이고요. 다섯 배입니다. 한국어 기술 문서가 외래어로 가득하다는 걸 생각하면, 문장 배율 1.3배보다 이쪽이 실제 비용에 더 크게 작용합니다.
반대 방향도 있습니다. 서울은 1토큰인데 Seoul은 2토큰입니다. 한국도 1토큰, Korea는 2토큰입니다. 사전에 통째로 올라간 낱말은 한국어가 더 쌉니다. 규칙은 단순합니다. 자주 쓰이는 말은 통째로 등재돼 싸고, 드문 조합은 쪼개져 비쌉니다. 뷁 같은 희귀 음절은 한 글자가 2토큰입니다. 같은 이유로 자모가 분리된 파일명은 최대 여덟 배까지 벌어집니다.
돈으로 환산하면 얼마인가
현재 API 단가는 100만 토큰 기준으로 이렇습니다.
| 모델 | 입력 | 캐시된 입력 | 출력 |
|---|---|---|---|
| GPT-5.6 Sol | $5.00 | $0.50 | $30.00 |
| GPT-5.6 Terra | $2.00 | $0.20 | $12.00 |
| GPT-5.6 Luna | $0.20 | $0.02 | $1.20 |
앞의 실무 프롬프트 5개를 다시 보면 한국어가 영어보다 56토큰 더 듭니다. 프롬프트 하나당 11토큰꼴입니다. Sol 입력 단가로 치면 하루에 1,000번을 보내도 한 달에 2달러가 안 됩니다. 대화하듯 쓰는 용도라면 한국어 토큰 배율은 사실상 신경 쓸 일이 아닙니다.
문제는 분량이 커질 때입니다. 10만 자짜리 한국어 문서는 약 41,300토큰입니다. 같은 내용의 영어라면 3만 토큰 안쪽입니다. 차이가 1만 1천 토큰입니다.
이걸 에이전트가 반복해서 다시 읽는 구조라면 그 차이가 호출 횟수만큼 곱해집니다. 한 번 읽고 마는 작업에서는 무시해도 되고, 같은 문서를 계속 다시 넣는 작업에서는 무시하면 안 됩니다.
컨텍스트 창은 돈과 다른 문제입니다
비용보다 먼저 체감되는 건 한도 쪽입니다. 토큰이 1.3배 든다는 말은 같은 컨텍스트 창에 들어가는 한국어 분량이 그만큼 줄어든다는 뜻이기도 합니다.
여기에는 돈으로 해결되지 않는 성격이 있습니다. 결제로 단가를 낮출 수는 있어도, 창 크기가 정해진 이상 넣을 수 있는 원고 분량은 늘지 않습니다. 긴 문서를 통째로 넣고 작업하다 잘리는 경험을 자주 하신다면, 한국어라서 손해 보는 폭이 대략 30% 정도라고 잡고 나눠 넣는 편이 낫습니다.
이 측정이 답하지 못하는 것
정직하게 밝혀 둘 부분이 있습니다.
OpenAI 계열만 쟀습니다. tiktoken은 OpenAI 인코딩입니다. 클로드나 제미나이는 각자 다른 방식을 쓰기 때문에 이 숫자를 그대로 옮기면 안 됩니다. 방향은 비슷할 가능성이 높지만 확인한 건 아닙니다.
재료가 29쌍입니다. 공식 문서 24쌍에 프롬프트 5쌍이라 표본이 큰 편은 아닙니다. 분야를 법률이나 의료 문서로 바꾸면 배율이 달라질 수 있습니다. 실제로 문단별 편차가 1.08배에서 1.50배까지 벌어졌습니다.
출력 토큰은 안 쟀습니다. 여기서 잰 것은 전부 입력 쪽입니다. 출력 단가가 입력의 여섯 배라는 점을 생각하면, 답변을 한국어로 받을 때의 배율이 실제 비용에는 더 크게 작용합니다. 그건 모델이 얼마나 길게 답하느냐에 달려 있어서 같은 방식으로 재기 어렵습니다.
✅ 체크리스트
- 쓰고 있는 모델이
o200k_base세대인지 확인했다. 구세대 모델이면 한국어 손해가 두 배다 - 대화 용도라면 한국어 토큰 배율은 무시하기로 정했다
- 같은 문서를 반복해서 넣는 작업이라면 캐시된 입력 단가를 확인했다
- 기술 문서라면 외래어를 한글로 적을지 영어로 둘지 정해뒀다
- 긴 원고는 한국어 기준으로 30% 줄여 잡고 나눠 넣는다
마무리
한국어 토큰은 지금 세대 모델에서 영어의 1.3~1.4배입니다. 두세 배라는 말은 GPT-4 시절에는 맞았고 지금은 낡았습니다.
글자 수로는 한국어가 62%밖에 안 쓰는데 토큰이 늘어나는 이유는 글자 하나를 쪼개는 비용이 두 배이기 때문이고, 그 격차가 가장 크게 벌어지는 자리는 문장이 아니라 프롬프트·컴포넌트 같은 외래어 표기입니다.
숫자를 직접 확인하고 싶으시면 OpenAI 요금 문서에서 단가를, tiktoken 라이브러리에서 토큰 수를 각각 재보실 수 있습니다. 위에 쓴 문장들을 그대로 넣으면 같은 값이 나옵니다.
콘텐츠 제작·자동화와 관련된 글도 함께 보면 흐름이 잘 잡힙니다.
이 글은 한국어 AI 실측 묶음에 속합니다. 같은 주제의 글을 배우는 순서대로 묶어 두었으니 묶음 페이지에서 이어 보세요.
글쓴이 · K.Lee — 파티시에로 일하며 AI·자동화 도구를 실무에 매일 씁니다. 확인한 범위와 확인하지 못한 범위를 글 안에 밝힙니다. 운영자 소개 · 편집 원칙 · 수정 정책
답글 남기기