보고서.pdf를 찾는 스크립트가 보고서.pdf를 못 찾습니다. 화면에는 분명 같은 글자가 떠 있는데 결과는 0건입니다. 압축해서 보낸 파일이 상대 컴퓨터에서 φò£Ω╕Ç로 열리기도 합니다. 둘 다 한글 파일명 깨짐으로 뭉뚱그려 부르지만 원인은 네 갈래로 갈립니다. 맥에서 직접 재현해 바이트 단위로 확인했습니다.
📌 핵심 요약
- 원인이 하나가 아닙니다. 정규화·zip 플래그·HTTP 헤더·코드의 문자열 비교 네 갈래입니다.
한글파일.txt는 8자 16바이트가 될 수도, 15자 37바이트가 될 수도 있습니다. 화면 표시는 똑같습니다.- 정규식
[가-힣]+가 한글 파일명에서 0글자를 잡는 경우가 있습니다. 오류도 안 납니다.
파일 정리 스크립트를 짜는 사람, 맥과 윈도우를 오가며 파일을 주고받는 사람, 파일 목록을 AI에 넘겨 작업시키는 사람에게 해당하는 이야기입니다.
한글 파일명 깨짐의 원인 네 가지
1. 같은 이름이 두 가지 바이트로 존재합니다
한글은 완성형 글자 하나로 쓸 수도 있고, 초성·중성·종성을 따로 쌓아 만들 수도 있습니다. 앞을 NFC, 뒤를 NFD라고 부릅니다(유니코드 표준 UAX #15에 정의된 이름입니다). 눈에는 구분이 안 갑니다.
| 화면 표시 | 파이썬 글자 수 | UTF-8 바이트 | |
|---|---|---|---|
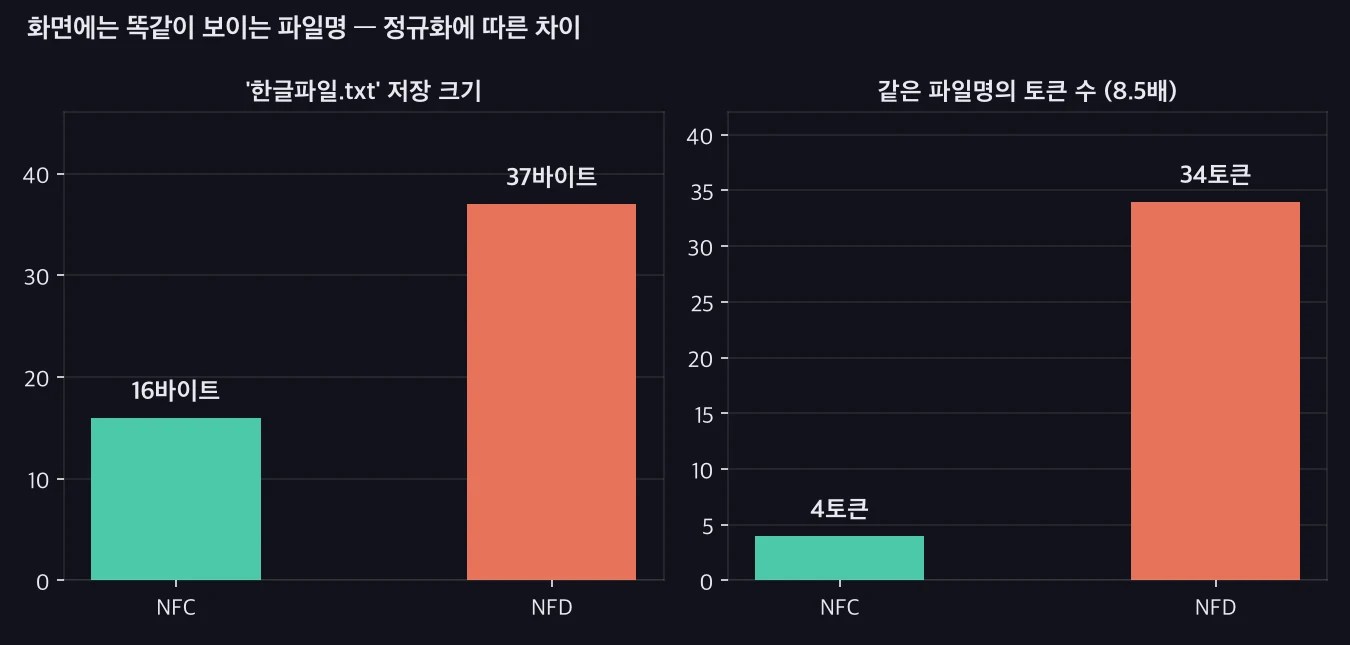
| NFC | 한글파일.txt | 8 | 16 |
| NFD | 한글파일.txt | 15 | 37 |
같은 파일 이름인데 바이트가 두 배 넘게 차이 납니다. NFD의 코드포인트를 들여다보면 U+1112 U+1161 U+11AB처럼 자모가 따로 서 있습니다. 맥에서 파일명이 ㅎㅏㄴㄱㅡㄹ처럼 풀려 보이는 현상, 검색하면 “자소 분리”로 나오는 그것이 이겁니다.
여기가 헷갈리는 지점입니다. 파일시스템은 이 차이를 무시합니다. NFC로 만든 파일을 NFD 경로로 열어도 정상적으로 열립니다. 그래서 파일 자체는 멀쩡히 잘 돌아갑니다. 문제는 파일시스템 바깥에서 터집니다.
2. 맥에서 압축한 zip은 플래그를 안 켭니다
zip 규격에는 “파일명이 UTF-8이다”라고 알리는 표시가 있습니다. 헤더의 11번 비트입니다. 이걸 켜지 않으면 압축을 푸는 쪽은 규격대로 옛날 인코딩(cp437)으로 해석해야 합니다.
맥에서 만든 zip을 열어봤습니다.
| 압축 방법 | UTF-8 플래그 | 실제 저장된 바이트 |
|---|---|---|
zip 명령 |
꺼짐 | UTF-8 |
ditto (Finder가 쓰는 경로) |
꺼짐 | UTF-8 |
바이트는 UTF-8로 넣어놓고 UTF-8이라고 말은 안 하는 상태입니다. 규격을 지키는 압축 해제 프로그램이 이걸 열면 φò£Ω╕Çφîî∞¥╝.txt가 됩니다. 한국 윈도우에서 흔히 쓰는 cp949로 읽으려 하면 아예 디코딩 오류가 납니다.
받는 쪽 잘못이 아닙니다. 보내는 쪽이 규격대로 표시를 안 한 것입니다.
3. HTTP 헤더에는 한글을 못 넣습니다
파일을 웹으로 올리거나 내려받을 때 이름은 Content-Disposition 헤더에 실립니다. 그런데 HTTP 헤더는 규격상 latin-1 범위만 허용합니다. 한글을 그대로 넣으면 이렇게 됩니다.
UnicodeEncodeError: ordinal not in range(256) — 첫 글자 한에서 바로 막힙니다.
우회 규격이 있긴 합니다. filename*=UTF-8'' 뒤에 퍼센트 인코딩을 붙이는 방식입니다.
filename*=UTF-8''%ED%95%9C%EA%B8%80%ED%8C%8C%EC%9D%BC.txt
8자짜리 이름이 40자가 됩니다. 다섯 배입니다. 그리고 이 방식을 모든 서버와 클라이언트가 제대로 처리하지는 않습니다. 자동화 파이프라인에서 파일을 API로 올릴 때 한글 이름을 영문으로 바꿔 넣는 코드가 흔한 이유가 이겁니다. 우아해서가 아니라 그게 제일 안 깨집니다.
4. 코드가 조용히 틀립니다
앞의 셋은 오류 메시지라도 뜹니다. 네 번째가 제일 고약합니다. 아무 일도 없었다는 듯 틀린 답을 내놓습니다.
NFC와 NFD로 된 보고서.pdf 두 개를 놓고 흔히 쓰는 연산을 돌려봤습니다.
| 연산 | NFC | NFD |
|---|---|---|
len() |
7 | 10 |
'보고서' in 이름 |
True | False |
.endswith('서.pdf') |
True | False |
정규식 [가-힣]+ 매칭 글자 수 |
3 | 0 |
두 이름을 함께 set()에 넣으면 크기가 2로 나옵니다. 중복 제거가 안 됩니다.
정규식 줄을 다시 보시기 바랍니다. [가-힣]은 완성형 글자 구간이라 자모가 흩어진 NFD에서는 하나도 걸리지 않습니다. 한글을 걸러내는 코드가 조용히 빈 결과를 돌려주고, 로그에는 “0건 처리 완료”가 찍힙니다.
파일 이름 길이 제한 검사도 마찬가지입니다. 같은 이름이 7자로도 10자로도 세어집니다. 30자 제한을 걸어둔 업로드 폼이 어떤 파일은 받고 어떤 파일은 거부하는 이유가 여기 있을 수 있습니다.
파일 목록을 AI에 넘길 때는 더 커집니다
정규화 문제는 AI 도구에서 비용으로도 나타납니다. 파일 목록을 그대로 붙여넣어 정리를 시키는 경우가 많은데, NFD 이름은 토큰을 훨씬 많이 먹습니다.
| 파일명 | NFC | NFD | 배율 |
|---|---|---|---|
| 한글파일.txt | 4토큰 | 34토큰 | 8.5배 |
| 2026년-분기보고서-최종.xlsx | 12토큰 | 62토큰 | 5.2배 |
| 제안서_초안_v3.docx | 10토큰 | 41토큰 | 4.1배 |
문장에서는 한국어가 영어의 1.3배쯤 듭니다. 그런데 자모가 분리된 파일명은 여덟 배까지 벌어집니다. 자모 하나하나가 사전에 없는 조각이라 통째로 쪼개지기 때문입니다. 파일 300개 목록을 넣었는데 컨텍스트가 이상하게 빨리 찬다면 이걸 의심해볼 만합니다.
어떻게 막나
한글 파일명 깨짐은 원인이 넷이라 대응도 자리마다 다릅니다.
코드를 짠다면 입구에서 한 번 맞춥니다. 파일 목록을 읽어들이는 즉시 unicodedata.normalize("NFC", 이름)을 통과시키고, 그 뒤로는 NFC만 다룹니다. 비교·검색·정렬 전에 양쪽을 같은 방식으로 정규화하지 않으면 어떤 대책도 소용없습니다.
압축해서 보낸다면 플래그를 켜는 도구로 바꿉니다. 맥에 기본으로 깔린 zip은 옵션으로 해결되지 않았습니다. -UN=UTF8을 주면 short option 'N' not supported로 거부합니다. 도움말에도 “유니코드 지원으로 컴파일된 경우에만” 저장한다고 적혀 있는데, 애플이 넣은 빌드가 그 경우가 아닌 듯합니다. 파이썬 zipfile로 만들어 확인해보니 플래그가 제대로 켜졌습니다. 스크립트로 압축하는 파이프라인이라면 그쪽으로 옮기면 되고, 손으로 보내는 거라면 받는 쪽이 한국 윈도우일 때는 파일명을 영문으로 바꾸는 편이 사고가 없습니다.
API로 올린다면 파일명을 영문으로 변환합니다. 한글 이름은 사람이 보는 자리(본문, 화면 표시)에 두고, 전송 경로에는 ASCII 이름을 씁니다. 두 이름을 매핑 표로 들고 다니면 화면에서는 한글을 유지하면서 전송은 안전해집니다.
AI에 넘기기 전에는 정규화합니다. 앞의 표대로 토큰이 여덟 배까지 벌어질 수 있어서, 목록이 길수록 효과가 큽니다.
이 글이 확인하지 않은 것
맥(APFS)에서 재현한 결과입니다. 예전 HFS+ 파일시스템은 NFD를 강제했지만 APFS는 넣은 대로 저장하고 비교할 때만 정규화를 무시합니다. 리눅스 파일시스템은 정규화 개념 자체가 없어서 NFC와 NFD가 서로 다른 파일로 공존할 수 있습니다. 그 경우는 직접 확인하지 않았습니다.
zip은 zip 명령과 ditto 두 경로만 봤습니다. 다른 압축 프로그램은 플래그를 켤 수 있습니다. 쓰시는 도구로 한 번 만들어 확인해보시는 편이 확실합니다.
✅ 체크리스트
- 파일 목록을 읽는 자리에서
NFC로 정규화하는 코드를 넣었다 - 문자열 비교·검색 전에 양쪽을 같은 방식으로 정규화한다
- 한글을 거르는 정규식이
[가-힣]이라면 NFD 입력에서 0건이 나올 수 있다는 걸 안다 - 압축해서 보낼 때 UTF-8 플래그가 켜지는 도구인지 확인했다
- API 전송 경로에는 ASCII 파일명을 쓰고, 한글 이름은 표시용으로 따로 들고 있다
마무리
한글 파일명 깨짐은 증상이 하나로 보여도 원인이 넷입니다. 파일시스템은 정규화 차이를 무시해서 파일 자체는 잘 열리고, 그래서 문제가 zip·HTTP·코드 쪽으로 넘어간 뒤에야 드러납니다. 가장 위험한 건 오류를 내지 않고 빈 결과를 돌려주는 네 번째입니다.
대응은 한 줄로 줄어듭니다. 이름이 들어오는 자리에서 NFC로 맞추고, 나가는 자리에서는 ASCII로 바꾼다. 위 실험은 unicodedata와 zipfile 같은 파이썬 기본 모듈로 그대로 재현할 수 있습니다.
콘텐츠 제작·자동화와 관련된 글도 함께 보면 흐름이 잘 잡힙니다.
이 글은 한국어 AI 실측 묶음에 속합니다. 같은 주제의 글을 배우는 순서대로 묶어 두었으니 묶음 페이지에서 이어 보세요.
글쓴이 · K.Lee — 파티시에로 일하며 AI·자동화 도구를 실무에 매일 씁니다. 확인한 범위와 확인하지 못한 범위를 글 안에 밝힙니다. 운영자 소개 · 편집 원칙 · 수정 정책
답글 남기기